Sistemi europei di calcolo accelerato

GRIFO 32.Una macchina più grande.

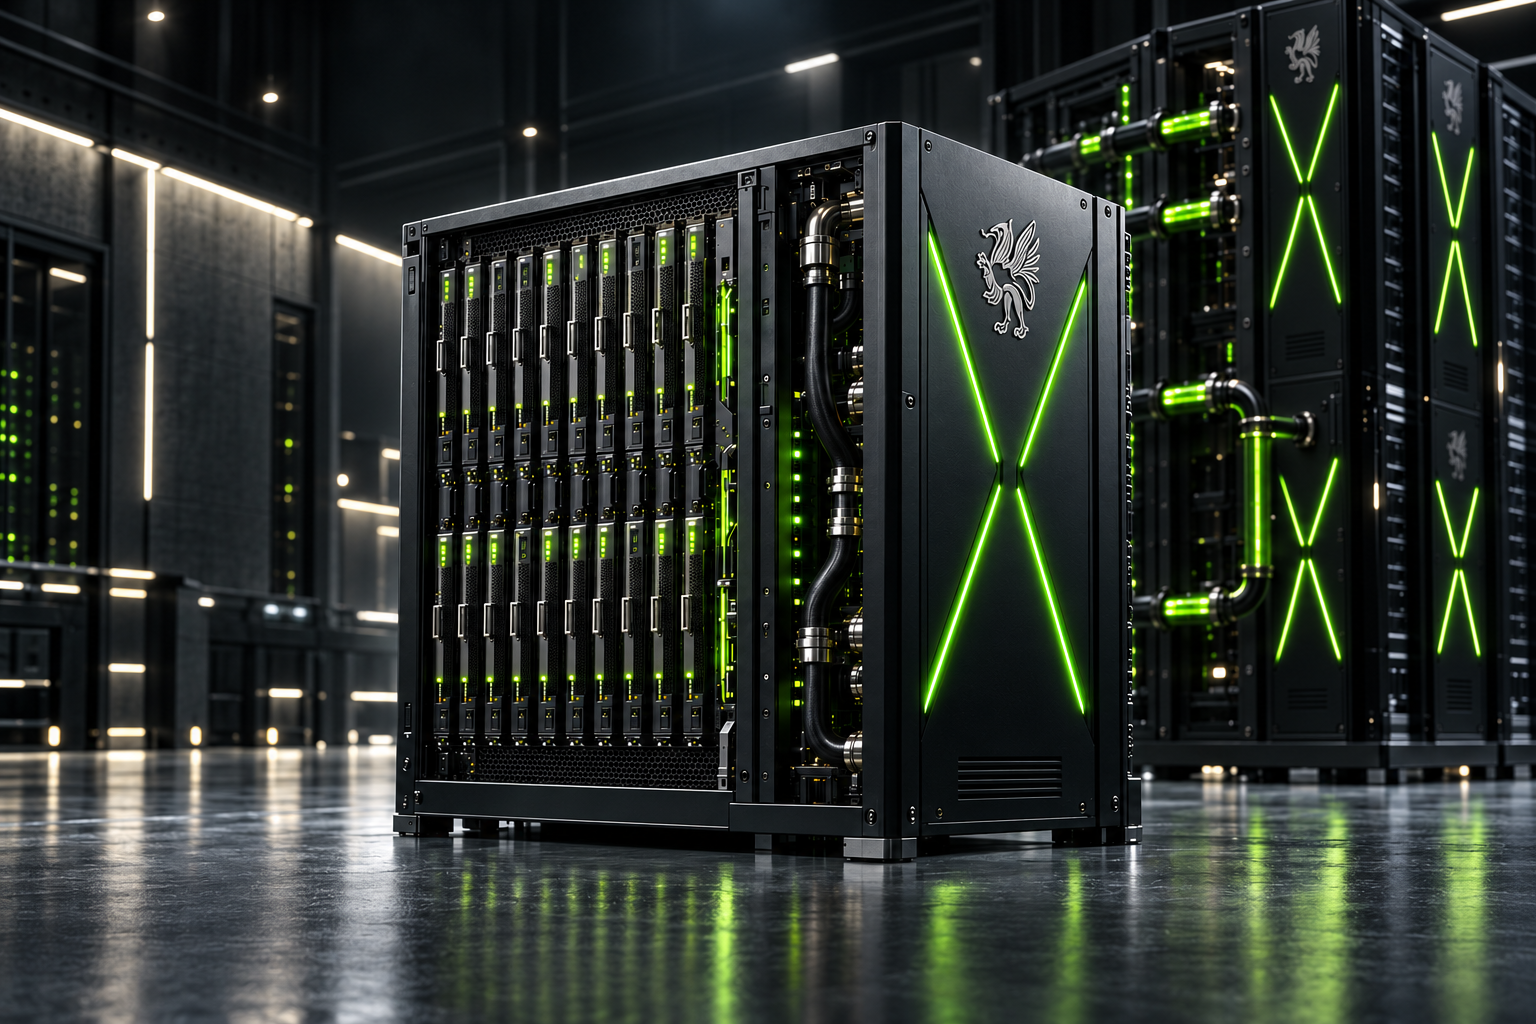
Billi Dynamics progetta i sistemi GRIFO per mantenere più acceleratori, movimento dei dati e controllo all’interno di un’unica architettura locale coordinata.

GRIFO 32 · 32 GPU per modulo · scale-up fino a 128 — GRIFOTTO · 8 GPU · disponibile ora

BILLI DYNAMICS · GRIFO ARCHITECTURE · EUROPEAN DEEP TECH

INSIDE GRIFO 32

32–128 GPUs.

Scale up within a single root complex.

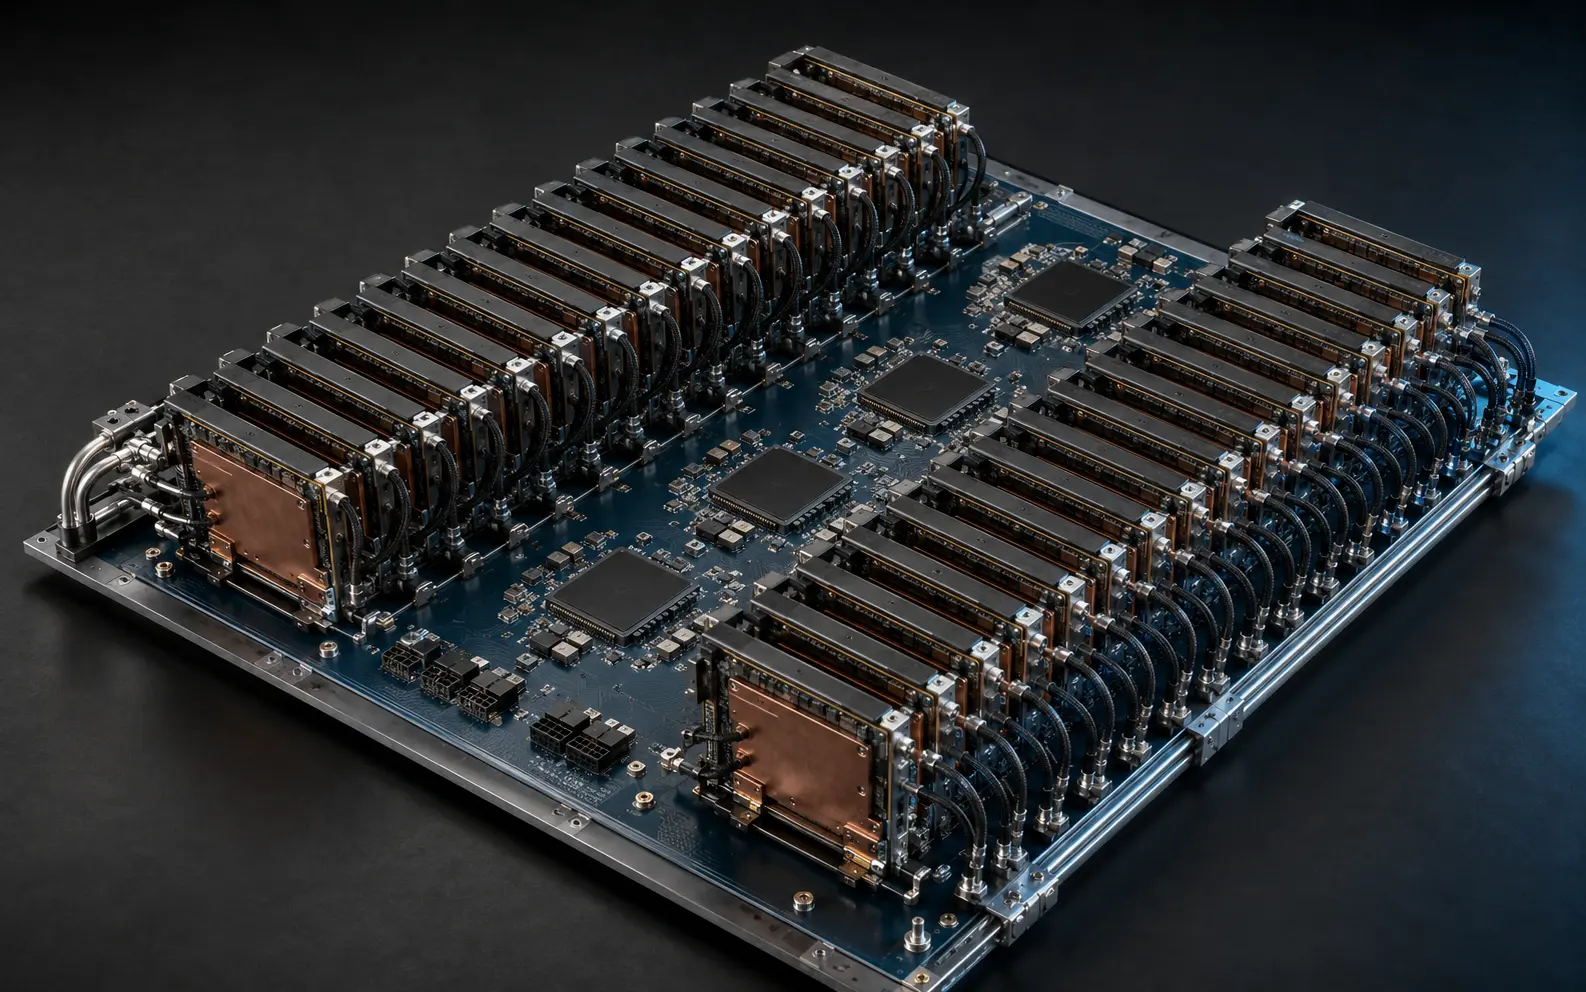
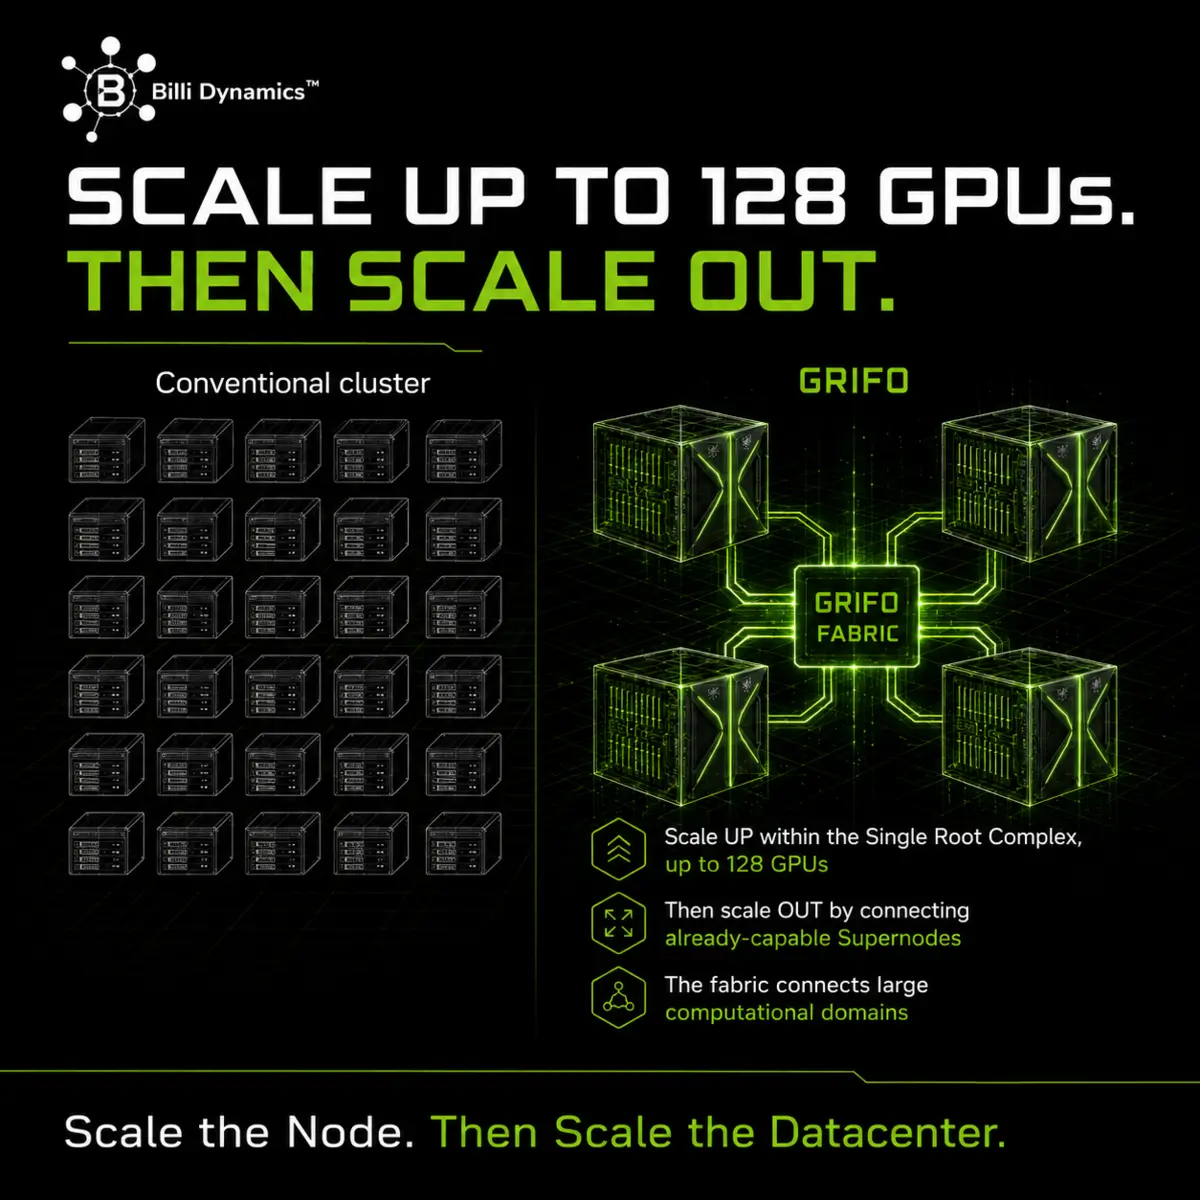
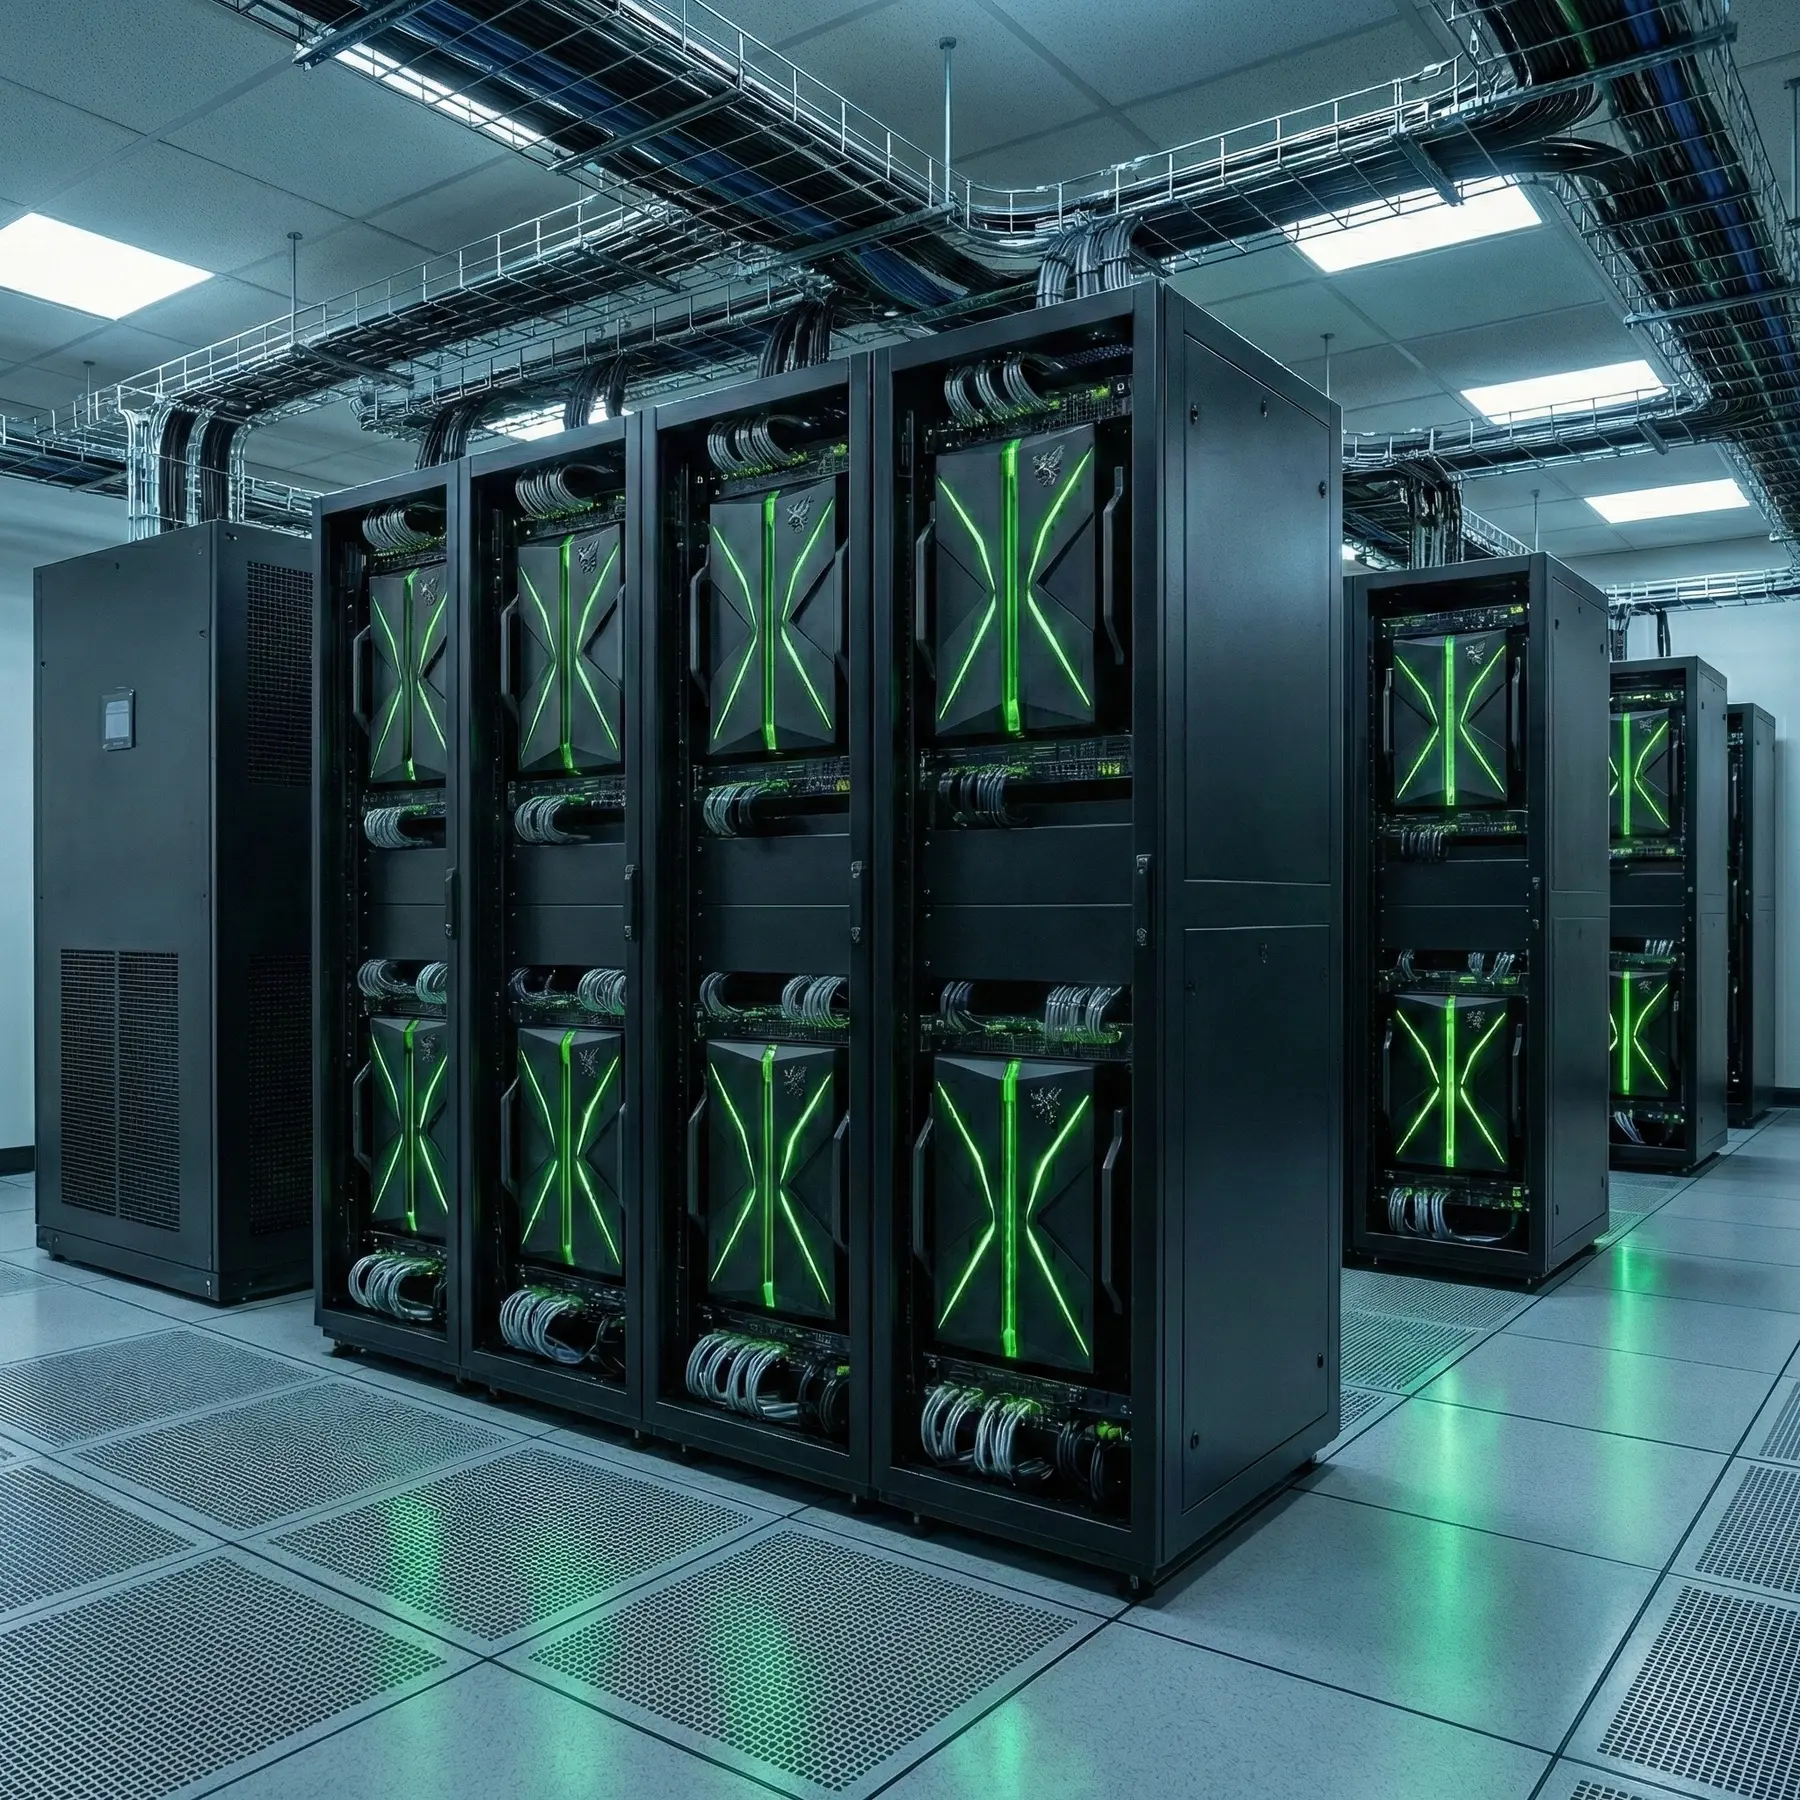
Il cuore resta il modulo GRIFO 32, con 32 GPU. Collegando fino a quattro moduli attraverso il fabric PCIe, l’architettura scala fino a 128 GPU in un unico root complex: più moduli fisici, un solo dominio PCIe coordinato.

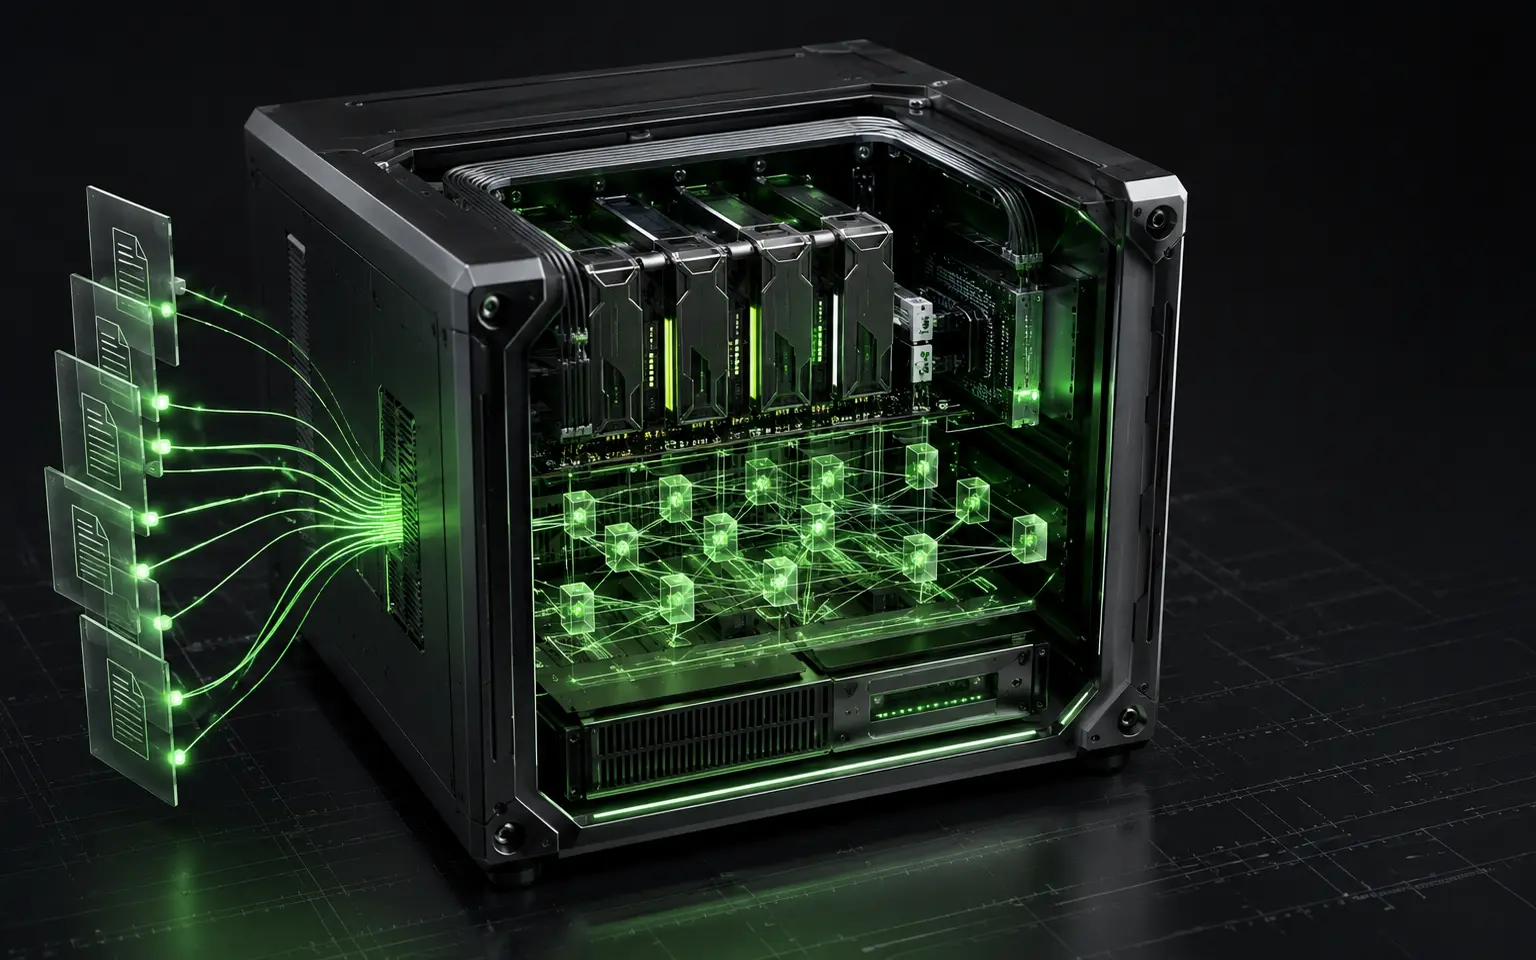
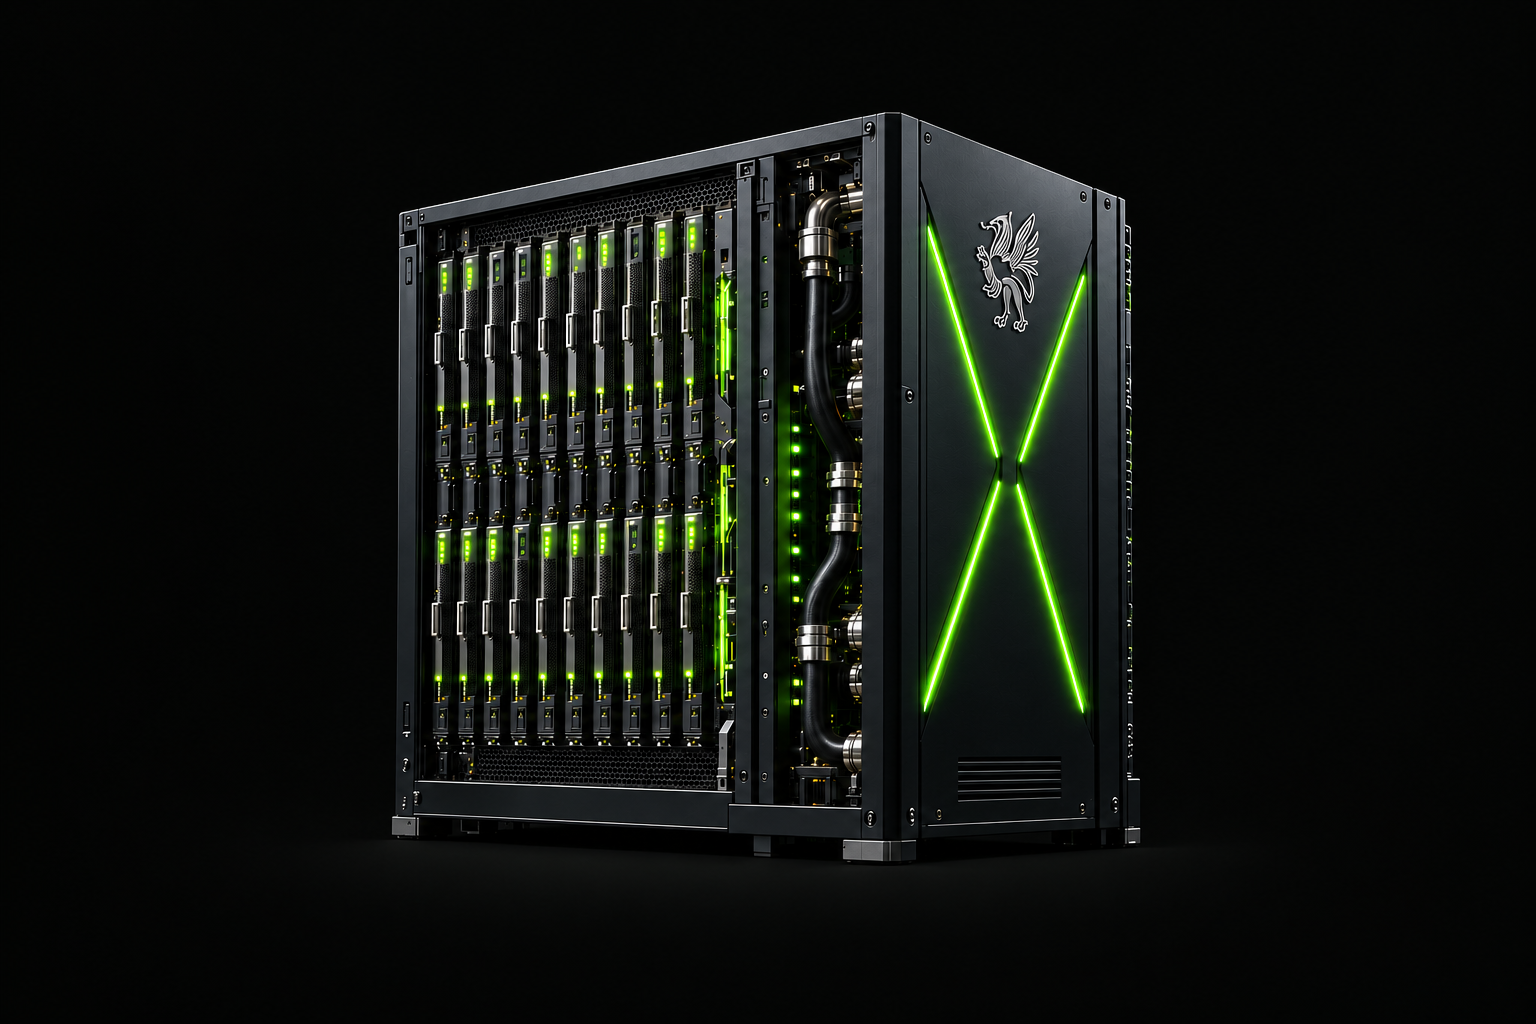
Rendering fotografico del GRIFO 32 aperto: acceleratori e circuito di raffreddamento all’interno dello chassis
GRIFO 32 · Vista interna · Rendering fotograficoDesigned by Billi Dynamics · System Architect: Emilio Billi

GRIFO, spiegato semplicemente

Un computer più grande. Non una stanza piena di computer.

GRIFO è un ecosistema proprietario di tecnologie progettate da Billi Dynamics. Fabric, controllo, alimentazione e raffreddamento fanno lavorare insieme gli acceleratori; la scelta del produttore resta aperta per acceleratori e periferiche I/O qualificati.

Scegli il sistema

GRIFOTTO o GRIFO 32?

Scegli in base al workload, alla scala necessaria e alle condizioni di installazione. GRIFOTTO riunisce otto acceleratori in una macchina completa; GRIFO 32 parte da un modulo a 32 acceleratori ed estende il dominio locale attraverso il suo fabric PCIe.

DUE RUOLI DIVERSI
08

Macchina completa

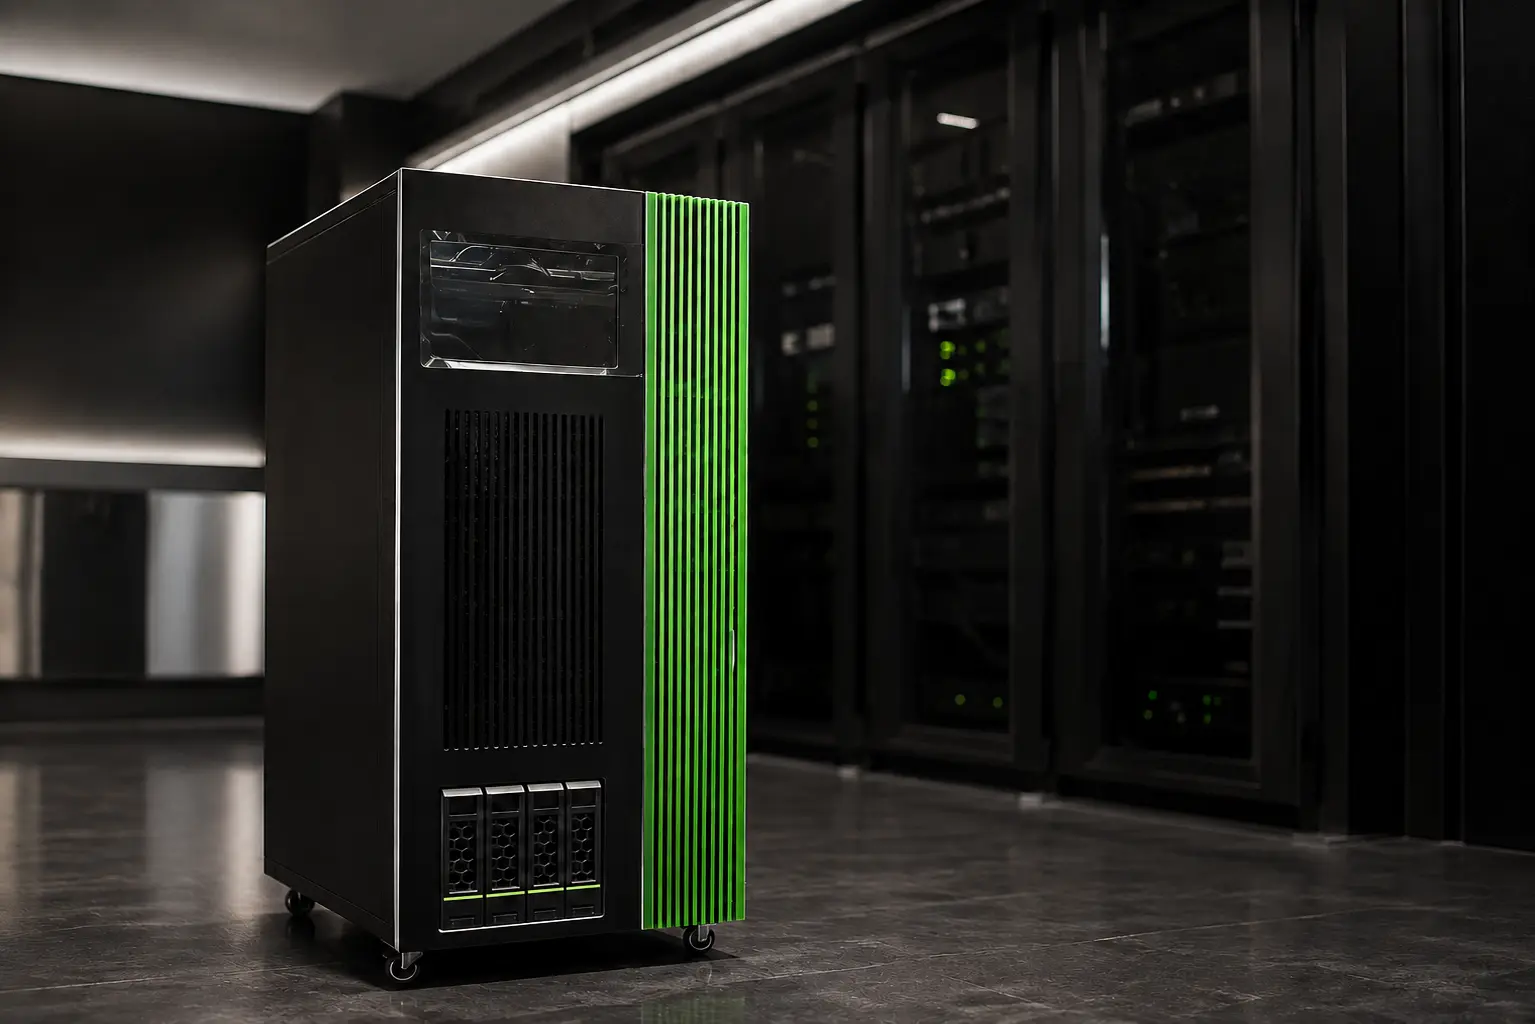
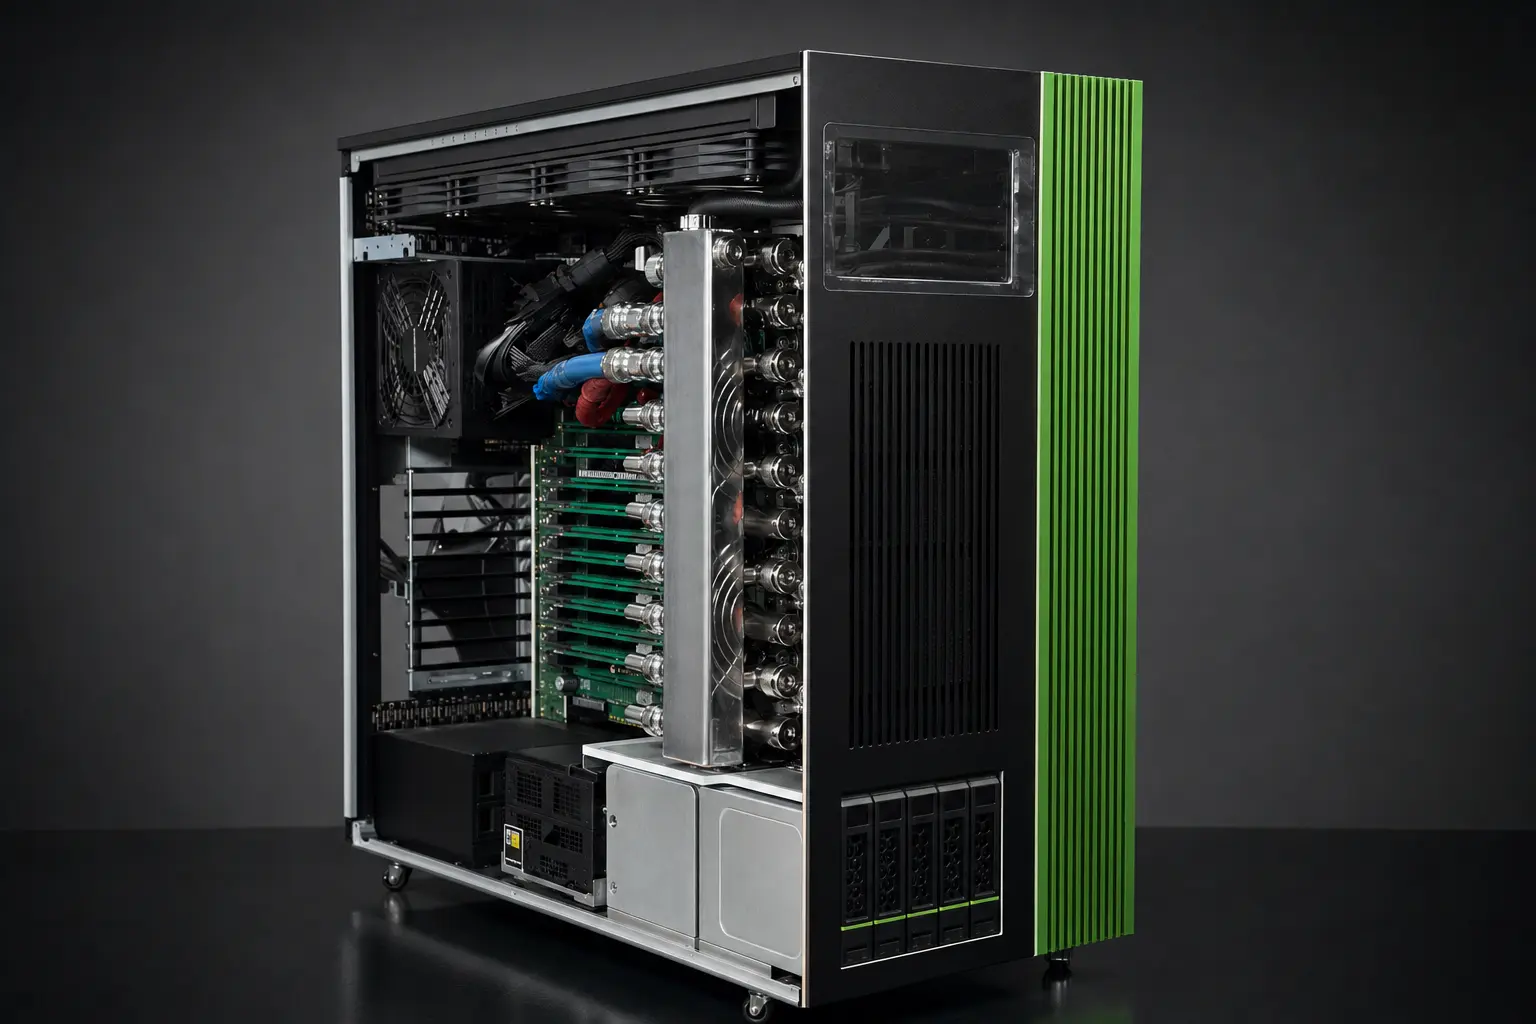
GRIFOTTOUn sistema autonomo a 8 acceleratori, configurabile e ordinabile ora.
32

Ecosistema scale-up modulare

GRIFO 3232 GPU per modulo di base. Fino a quattro moduli collegati tramite fabric PCIe in un unico root complex.
LivelloGRIFOTTOGRIFO 32
01Identità del sistemaSistema completoUna macchina autonoma pronta a ospitare il workload.Ecosistema di supernodi modulareFabric, alimentazione, termica e controllo sono progettati insieme; acceleratori e I/O qualificati restano selezionabili.
02Dominio locale di accelerazione8 posizioni GPU Gen5 x16Dominio dual-socket e dual-root NUMA.32 acceleratori per modulo · fino a 128 GPUFino a quattro moduli GRIFO 32 collegati tramite fabric PCIe all’interno di un unico root complex.
03FabricConnessioni Gen5 x16 dedicatePercorsi PCIe interni definiti e validati a livello di macchina.Fabric PCIe Gen5 commutato single-rootCollega gli acceleratori nel modulo ed estende il dominio PCIe condiviso tra i moduli.
04Rete di scale-out1 posizione NIC/HCA pronta per 400GCollegamento a storage o infrastruttura esterna in funzione dell’installazione.Scale-up locale, poi scale-outNIC/HCA ad alta velocità aggiuntive collegano supernodi già capaci, storage e data center.
05Architettura di raffreddamentoRaffreddamento a liquido dell’intero sistemaCPU, acceleratori e componenti critici sono gestiti nella stessa macchina.Architettura termica a tre livelliCold plate, distribuzione/CDU e dissipazione di facility vengono dimensionati con il dominio.
06Architettura di alimentazioneDistribuzione integrata nella macchinaAlimentazione configurata sul numero e sull’envelope degli acceleratori installati.Power delivery di dominioDistribuzione, protezioni, cablaggio e carico termico sono coordinati sull’intero ecosistema.
07Controllo del sistemaBMC, firmware e validazione della topologiaControllo operativo completo del singolo sistema.Controllo coordinato del dominioEnumerazione, switching, firmware, telemetria e validazione attraversano tutti i sottosistemi.
08Modello di installazioneSingola macchina o nodo di un clusterIdeale per laboratori, AI/HPC, simulazione e installazioni compatte.Building block del data centerPrima amplia la macchina locale; poi collega domini GRIFO completi su scala di infrastruttura.
09StatoConfigurabile e ordinabile oraSistema di riferimento documentato e in validazione reale.Architettura flagshipIndustrializzazione e validazione del dominio a 32 acceleratori.
“Parti da 32 GPU. Collega fino a quattro moduli GRIFO 32 tramite fabric PCIe. Scala fino a 128 GPU in un unico root complex.”

APPLICAZIONI STRATEGICHE

Dove GRIFO fa la differenza.

Grandi dati da tenere vicini alle GPU. Scambi diretti fra acceleratori. Molti lavori da eseguire insieme. È qui che l’architettura diventa un vantaggio per chi usa il sistema.

01

Più dati sulle GPU

Capacità aggregata per grandi modelli, grafi e simulazioni.

02

Scambi dentro GRIFO

Percorsi PCIe diretti per le applicazioni che li supportano.

03

Più lavori insieme

GPU dedicate a richieste, campioni e scenari indipendenti.

01 / 6 APPLICAZIONI

AI privata e inferenza

05 / INFERENZA AI · MIXTURE OF EXPERTS

Grandi modelli a esperti, sotto il tuo controllo.

Un modello Mixture-of-Experts seleziona gruppi specializzati di parametri per ogni token. GRIFO 32 offre spazio per distribuire questi esperti fra le GPU, mentre il fabric PCIe trasporta gli scambi richiesti dal software di inferenza.

  • Mantenere i pesi sulle GPU quando pesi, contesto e memoria di esecuzione trovano spazio insieme.
  • Distribuire gli esperti fra gli acceleratori riducendo il ricorso alla memoria CPU per motivi di capacità.
  • Eseguire grandi modelli a pesi aperti in locale, controllando dati e scelta del modello.

Per chiPubblica amministrazione, settori regolamentati e team AI aziendali

INFERENZA AI · MIXTURE OF EXPERTS
Scenario ideale: parallelismo per esperti e pipeline adeguati. Instradamento e costo degli scambi vanno validati sul carico reale.

06 / AI A CONTESTO LUNGO · KV-CACHE

Più spazio per conversazioni lunghe e utenti simultanei.

Un servizio AI conserva una memoria di lavoro di ogni conversazione: la KV-cache. Documenti più lunghi e più utenti simultanei aumentano questa esigenza. GRIFO permette al software di assegnare GPU alla lettura dei prompt, alla generazione delle risposte e al contesto conservato, dentro un solo sistema.

  • Dedicare memoria GPU a contesti più lunghi e sessioni concorrenti.
  • Trasferire lo stato del contesto tramite percorsi interni diretti, se supportati dal motore di inferenza.
  • Bilanciare elaborazione dei prompt e generazione delle risposte sulla domanda del servizio.

Per chiProvider di inferenza, agenti AI, assistenti di programmazione, AI legale e documentale

AI A CONTESTO LUNGO · KV-CACHE
Lunghezza del contesto e utenti simultanei dipendono da modello, precisione della cache, memoria e software di inferenza.
AI privata e conoscenza aziendale

AI privata e conoscenza aziendale

Trasformare i documenti interni in un servizio di conoscenza consultabile. Modelli locali e pipeline di ricerca aiutano i collaboratori a trovare informazioni mantenendo i dati nell’organizzazione.

  • Capacità dedicata a reparti e servizi interni.
  • Controllo locale di documenti, modelli e regole di accesso.
Documenti e pratiche digitali

Documenti e pratiche digitali

Estrarre, classificare e cercare dati in fatture, contratti e fascicoli. Pagine e lotti separati possono lavorare su GPU diverse con OCR e modelli documentali compatibili.

  • Elaborare più lotti di documenti in contemporanea.
  • Mantenere archivi aziendali e amministrativi in sede.
Servizi AI per molti utenti

Servizi AI per molti utenti

Erogare assistenti, trascrizione, embedding e modelli visivi con più repliche o servizi GPU separati. Le richieste indipendenti sfruttano il parallelismo senza obbligare tutte le GPU a sincronizzarsi a ogni passo.

  • Gestire più richieste e servizi contemporaneamente.
  • Assegnare acceleratori alla domanda ricorrente dei servizi.
Sviluppo e adattamento dei modelli

Sviluppo e adattamento dei modelli

Eseguire fine-tuning indipendenti, adattamenti LoRA o QLoRA, valutazioni e ricerche di parametri. I team possono confrontare più esperimenti con strumenti compatibili con le GPU.

  • Condurre esperimenti e campagne di validazione in parallelo.
  • Adattare i modelli ai dati aziendali su infrastruttura dedicata.
02 / 3 APPLICAZIONI

Dati e database GPU

04 / ANALISI DI GRAFI · DATABASE GPU

Trovare il legame che cambia la decisione.

Riconoscere relazioni nascoste fra transazioni, identità ed eventi. Grandi grafi e database nativi GPU possono mantenere i dati partizionati vicino agli acceleratori che li cercano, li collegano e li analizzano.

  • Mantenere dati di lavoro più grandi nella memoria delle GPU, nei limiti della capacità disponibile.
  • Combinare analisi parallele e accesso diretto supportato ai dati delle altre GPU.
  • Sostenere indagini antifrode, raccomandazioni e ricerca di conoscenza su infrastruttura locale.

Per chiBanche, fintech, telecomunicazioni, cyber intelligence e grafi di conoscenza aziendali

ANALISI DI GRAFI · DATABASE GPU
Servono un motore nativo GPU e un partizionamento adeguato: un database CPU non viene accelerato automaticamente.
Finanza quantitativa e rischio

Finanza quantitativa e rischio

Distribuire traiettorie Monte Carlo, scenari di stress e backtesting fra le GPU. Le prove indipendenti sfruttano naturalmente il parallelismo, prima dell’aggregazione dei risultati.

  • Valutare più scenari nelle campagne di analisi del rischio.
  • Mantenere portafogli e modelli proprietari sotto controllo locale.
Cybersecurity e analisi forense

Cybersecurity e analisi forense

Analizzare log, classificare file e cercare informazioni nei materiali di indagine con modelli compatibili con le GPU. Dataset e intervalli temporali possono lavorare in pipeline indipendenti nel perimetro aziendale.

  • Eseguire più pipeline di analisi e indagine in contemporanea.
  • Conservare evidenze sensibili e telemetria sull’infrastruttura locale.
03 / 7 APPLICAZIONI

Ricerca, simulazione e produzione

01 / SIMULAZIONE · CFD E PDE

La simulazione resta in un solo computer GPU.

Simulare l’aria intorno a un aereo, la combustione in un motore o l’evoluzione del clima. Le grandi griglie di calcolo vengono ripartite fra le GPU, che a ogni passo scambiano i dati ai confini delle rispettive porzioni.

  • Mantenere griglie più grandi nella memoria delle GPU, quando l’intero insieme di dati vi trova spazio.
  • Scambiare i dati delle porzioni adiacenti tramite il fabric PCIe interno.
  • Ridurre la dipendenza dalla rete esterna nel ciclo di simulazione.

Per chiAerospazio, automotive, energia, meteorologia e ricerca climatica

SIMULAZIONE · CFD E PDE
Scenario ideale: solutori GPU con scambi locali e dati dimensionati sulla memoria del sistema.

02 / DINAMICA MOLECOLARE · N-BODY

Esplorare più interazioni. Far avanzare la ricerca.

Studiare il movimento delle molecole, il comportamento dei materiali o l’interazione fra particelle. GRIFO sostiene sia campagne di simulazioni indipendenti sia implementazioni GPU che ridistribuiscono coordinate e forze fra porzioni interdipendenti.

  • Eseguire in parallelo più candidati molecolari o repliche di simulazione.
  • Usare trasferimenti diretti per gli scambi supportati fra GPU.
  • Tenere dati di ricerca e capacità di calcolo all’interno del laboratorio.

Per chiRicerca farmaceutica, chimica, materiali, astrofisica e fisica del plasma

DINAMICA MOLECOLARE · N-BODY
L’idoneità dipende dal solutore: FFT e ridistribuzioni a lungo raggio vanno misurate sulla topologia scelta.

03 / GENOMICA · PANGENOMICA

Più spazio per il grafo del genoma.

Assemblare genomi, confrontare campioni e navigare grafi pangenomici. In questi lavori può contare più mantenere accessibile una grande struttura di dati irregolare che raggiungere il massimo teorico delle operazioni di calcolo.

  • Distribuire grafi più grandi nella memoria di più GPU.
  • Accedere ai dati delle GPU vicine attraverso software compatibile e fabric locale.
  • Eseguire pipeline di campioni in parallelo, mantenendo i dati sensibili in sede.

Per chiGenomica di popolazione, medicina di precisione, agricoltura e sorveglianza dei patogeni

GENOMICA · PANGENOMICA
Servono strumenti GPU e una gestione esplicita dei dati: la memoria resta fisicamente distribuita fra gli acceleratori.
Controllo qualità industriale

Controllo qualità industriale

Analizzare i flussi delle telecamere per individuare difetti superficiali, verificare assemblaggi e ispezionare componenti. Linee e modelli separati possono avere risorse GPU dedicate.

  • Sostenere pipeline di ispezione simultanee su più linee.
  • Mantenere le immagini di produzione vicino ai sistemi di fabbrica.
Rendering e produzione visiva

Rendering e produzione visiva

Distribuire frame, scene e varianti di prodotto indipendenti fra le GPU. Motori di rendering compatibili trasformano il calcolo parallelo in più immagini per architettura, animazione, VFX e cataloghi digitali.

  • Produrre più frame o varianti nello stesso momento.
  • Riservare capacità locale alle scadenze ricorrenti di produzione.
Video e archivi audiovisivi

Video e archivi audiovisivi

Eseguire transcodifica, restauro, indicizzazione e localizzazione su clip o canali separati. GPU e software vanno scelti per i codec e le fasi di elaborazione richiesti.

  • Elaborare in parallelo lavorazioni video indipendenti.
  • Rendere più semplice consultare e riutilizzare grandi archivi audiovisivi.
Energia e previsioni operative

Energia e previsioni operative

Prevedere produzione rinnovabile e domanda, oppure analizzare gli impianti per la manutenzione predittiva. Siti, orizzonti temporali e varianti di modello possono diventare lavori GPU separati.

  • Valutare più siti e scenari di pianificazione contemporaneamente.
  • Combinare previsioni e analisi degli impianti su capacità dedicata.

DAL LABORATORIO ALLA PRODUZIONE

La capacità diventa lavoro completato.

GRIFOTTO per team e laboratori; GRIFO 32 per volumi maggiori e più servizi. Quando richieste e attività si possono separare, il valore cresce facendo lavorare più GPU in parallelo.

La scelta segue l’applicazione.

GRIFO privilegia capacità di memoria, accessi diretti e lavori paralleli. Il training denso con sincronizzazioni All-Reduce continue richiede una valutazione diversa e può beneficiare maggiormente di interconnessioni della classe NVLink. Memoria GPU aggregata non significa un’unica HBM a banda uniforme: software, partizionamento e comunicazioni determinano il risultato.

Applicazioni e illustrazioni dalle presentazioni Billi Dynamics «GRIFO Where It Wins» e «GRIFO Marketing». I benefici descrivono il posizionamento applicativo, non benchmark misurati o installazioni documentate. La configurazione va validata sul carico del cliente.

Piattaforme software

Dalla potenza alle applicazioni.

Scegli gli strumenti per lavorare sui tuoi dati, modelli e processi.

02Piattaforme software
01

Esecuzione dati e AI GPU-native

GRIFO DATA ENGINE

Portare il calcolo dove risiedono i dati, invece di spostare i dati attraverso strati di infrastruttura. GRIFO Data Engine avvicina operazioni relazionali, vettoriali e assistite dall’AI alla memoria degli acceleratori, trasformando grandi working set in decisioni più rapide ed efficienti.

Pensato perGrandi working set analitici, ricerca vettoriale e dati enterprise integrati con AI.

Vantaggi operativi

  • Meno trasferimenti tra CPU e acceleratori
  • Un solo percorso per operazioni relazionali, vettoriali e AI
  • Validazione costruita sulle query reali del cliente
Richiedi maggiori informazioni
GRIFO DATA ENGINE — Esecuzione dati e AI GPU-native
Modellato e derivatoArchitettura tecnica e validazione dei workload
02

AI privata per l’impresa

CONFIDENTIALGPT

Trasformare gli archivi riservati in intelligenza istituzionale utilizzabile, dentro il proprio perimetro di sicurezza. ConfidentialGPT aiuta a trovare evidenze, confrontare documenti, rilevare incoerenze e preparare decisioni senza esportare conoscenza sensibile verso cloud esterni.

Pensato perLegale, finanza, PA, ricerca e organizzazioni che gestiscono conoscenza sensibile.

Vantaggi operativi

  • La conoscenza sensibile resta locale o air-gapped
  • Risposte fondate su documenti e relazioni controllate
  • Ricerca, confronti, dossier e workflow più rapidi
Richiedi maggiori informazioni
CONFIDENTIALGPT — AI privata per l’impresa
Piattaforma in sviluppoSviluppo avanzato; disponibilità su richiesta
03

Intelligenza predittiva

PROFETA

Passare dai report che descrivono il passato agli scenari che illuminano la prossima decisione. PROFETA combina previsione, simulazione e contesto operativo per consentire alle organizzazioni di valutare le alternative prima che le conseguenze diventino costi.

Pensato perEnergia, industria, operations e pianificazione.

Vantaggi operativi

  • Anticipare domanda, rischio e cambiamenti operativi
  • Confrontare scenari alternativi prima di agire
  • Collegare le previsioni ai processi decisionali reali
Richiedi maggiori informazioni
PROFETA — Intelligenza predittiva
Piattaforma in sviluppoSoluzione in sviluppo
04

Intelligenza visiva e dei segnali

iVST

Dare occhi e orecchie ai sistemi operativi. iVST trasforma video, immagini e segnali complessi provenienti dai sensori in eventi correlati che i sistemi di ispezione, sicurezza e automazione possono comprendere e utilizzare.

Pensato perIspezione industriale, analytics multi-camera, sicurezza e sistemi autonomi.

Vantaggi operativi

  • Un unico livello di interpretazione per telecamere e segnali
  • Dai flussi grezzi a eventi operativi utilizzabili
  • Integrazione edge-to-system negli ambienti reali
Richiedi maggiori informazioni
iVST — Intelligenza visiva e dei segnali
Piattaforma in sviluppoSviluppo della soluzione e validazione progettuale
03Capacità ingegneristica
01

La definizione

Dagli acceleratori al circuito di raffreddamento, ogni parte contribuisce allo stesso sistema di calcolo.

01Il fabric PCIe collega acceleratori e moduli GRIFO 32 in un dominio locale condiviso. Pooling, gestione dell’I/O e topologia di comunicazione definiscono come raggiungere e coordinare le risorse.

02Alimentazione e raffreddamento a liquido dell’intero sistema sono progettati insieme al percorso dei dati. Il networking ad alte prestazioni offre le connessioni scale-out verso storage e altri domini di calcolo.

02Stack tecnologico proprietario Billi Dynamics
01Single-root PCIe fabric02GPU pooling03High-performance networking04Topologie di comunicazione ottimizzate
05Scale-out paths06Gestione avanzata dell’I/O07Power architecture08Full-system liquid cooling
03

Proprietà che un server tradizionale non possiede

01Alta densità di acceleratori
02Comunicazioni GPU-to-GPU a bassissima latenza
03Dominio PCIe condiviso
04Accesso diretto alle risorse
05Meno colli di bottiglia inter-node
06Continuità tra scale-up e scale-out
04 · PROGETTAZIONE DI SISTEMA · SCELTA DEI DISPOSITIVI

Agnostico solo per acceleratori e I/O

Seleziona acceleratori e periferiche I/O qualificati in base al workload, allo stack software e alle esigenze di acquisto. L’architettura di sistema GRIFO mantiene continuità mentre queste scelte evolvono.

NUCLEO BILLI DYNAMICS · ACCELERATORI + I/O QUALIFICATI

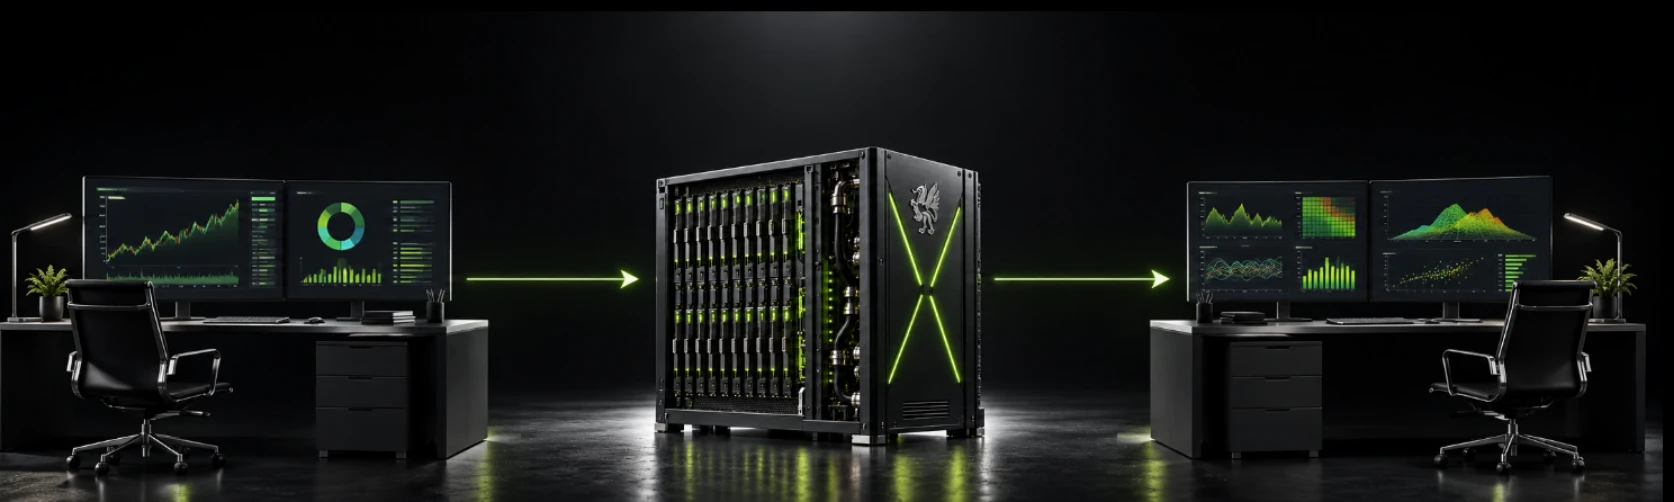
DA SERVER COLLEGATI IN RETE A UN UNICO DOMINIO COORDINATO

Molte macchine separate
01 · SERVER COLLEGATI IN RETE
Data center convenzionale

Ogni server ha un proprio confine. I dati devono attraversare ripetutamente una rete esterna a pacchetto.

Host indipendenti · rete esterna tra i nodi
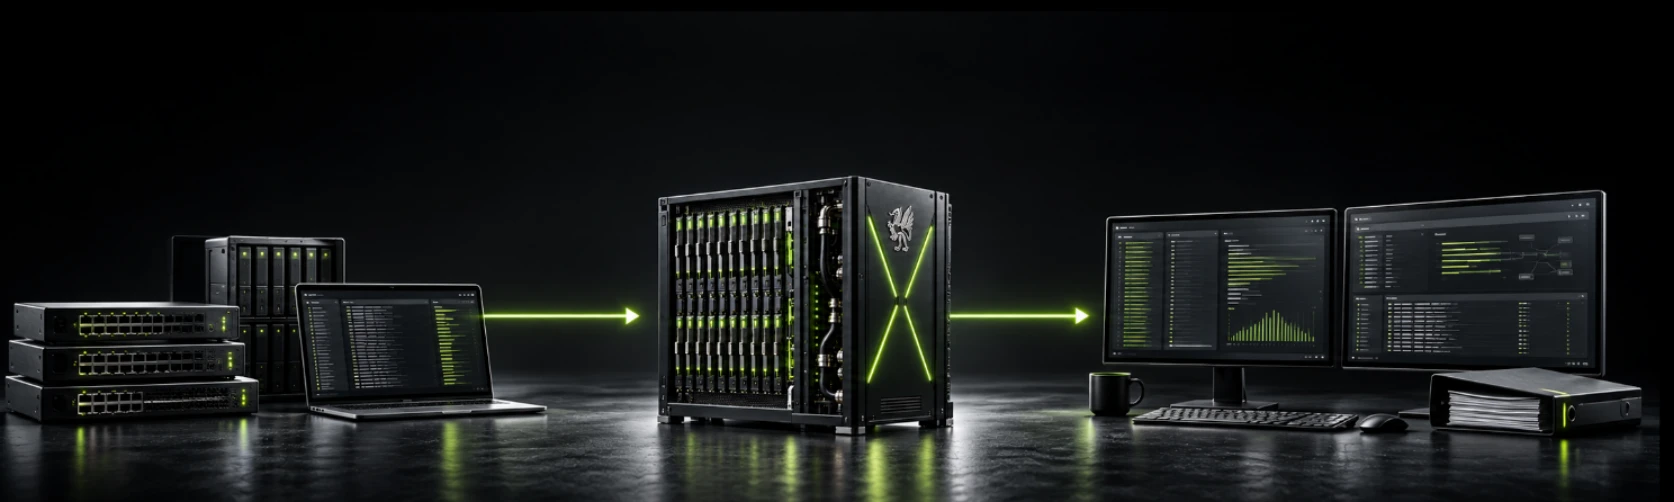
GRIFO 32: vista interna del singolo modulo da 32 GPU
02 · UN DOMINIO COORDINATO
Dominio locale GRIFO

Acceleratori, fabric e controllo vengono progettati come parti di una sola macchina locale più grande.

Modulo da 32 GPU · fino a 128 GPU collegando quattro moduli tramite fabric PCIe

Rendering illustrativi: a sinistra server collegati in rete, a destra il singolo modulo GRIFO 32. Il confronto a parità di acceleratori è presentato nella sezione seguente.

01

Che cosa cambia?

Gli acceleratori smettono di essere risorse isolate in server separati e diventano parti di un unico dominio di calcolo coordinato.

02

Perché è un supernodo?

Perché calcolo, memoria, fabric, controllo, alimentazione e raffreddamento sono progettati come parti di una sola macchina.

03

Perché serve ora?

L’AI è sempre più limitata dalla distanza dei dati, dall’energia e dal calore, non soltanto dalla velocità dei chip.

Il futuro non richiede semplicemente più GPU. Richiede una macchina capace di farle lavorare davvero insieme.

Con la crescita di modelli e dataset, spostare dati tra server isolati diventa sempre più costoso. La direzione architetturale è quindi inevitabile: ampliare la macchina locale utile prima di scalare attraverso il data center.

Studio architetturale · scenario di riferimento a 128 acceleratori

Lo stesso numero di acceleratori. Un’infrastruttura radicalmente diversa.

Lo studio attribuisce al cluster convenzionale il 15,6% di calcolo teorico in più. Poi segue ciò che il dato deve attraversare prima che quel calcolo possa trasformarsi in lavoro utile.

128 = 128128 acceleratori H200 in entrambe le architetture

Un punto di partenza volutamente conservativo

Entrambi i sistemi di riferimento contengono 128 acceleratori NVIDIA H200, nelle varianti di formato e potenza dichiarate dallo studio. Il confronto assume per il cluster un fat-tree 1:1 ideale e perfettamente ottimizzato e non confonde i FLOPS di picco con le prestazioni applicative.
Data center convenzionale
Tra macchine

16 nodi di calcolo indipendenti

16 nodi × 8 GPU = 128 GPU

Host indipendenti · rete esterna tra i nodi

Quattro moduli GRIFO 32 · fabric PCIe · un root complex
Dentro GRIFO

Un dominio coordinato a 128 acceleratori

4 moduli × 32 GPU = 128 GPU

Quattro moduli GRIFO 32 · fabric PCIe · un root complex

Rendering illustrativi delle architetture. Il confronto usa le configurazioni indicate sopra; il numero di unità raffigurate non rappresenta letteralmente la topologia dello studio.

Parametro dello studioData center convenzionaleGRIFO
CALCOLO TEORICOData center convenzionale126,6 PFLOPSGRIFO106,9 PFLOPS
PERCORSO DI COMUNICAZIONE MODELLATOData center convenzionale≥850 ns di limite fisicoGRIFO≈505 ns nel percorso locale commutato
INFRASTRUTTURA NEL PERCORSO LOCALEData center convenzionaleNIC · ottiche · switch InfiniBandGRIFOFabric PCIe Gen5 · nessun confine esterno a pacchetto

Segui un singolo scambio

PERCORSO DI COMUNICAZIONE MODELLATO

Tra macchine

  1. 01PCIe DMA
  2. 02stack RDMA
  3. 03NIC
  4. 04ottiche
  5. 05switch IB
  6. 06copia a destinazione

≥850 ns di limite fisico

Dentro GRIFO

  1. 01porta PCIe
  2. 02switch locali
  3. 03porta PCIe

≈505 ns nel percorso locale commutato

01

Il percorso diventa più corto

Il modello di riferimento colloca il percorso locale commutato di GRIFO intorno a 505 ns, mentre i soli componenti fisici del percorso di rete convenzionale totalizzano almeno 850 ns.

02

Meno confini consumano il budget

Lo scambio locale non deve più essere serializzato da una NIC, trasformato in collegamento ottico, commutato come pacchetto di rete e ricostruito su un altro server.

03

Il picco diventa una questione di sistema

Un vantaggio del componente sulla carta può essere superato dal tempo impiegato per muovere e coordinare i dati. È l’architettura completa a stabilire quanto calcolo raggiunge il workload.

“Il calcolo di picco è il numero di partenza. I confini decidono quanto ne arriva al workload.”
MODELLO DI STUDIO — NON UN BENCHMARK APPLICATIVO

I valori derivano dal modello analitico di riferimento dichiarato a 128 acceleratori. Non sono risultati applicativi misurati di GRIFO 32. Le prestazioni reali dipendono da acceleratore, topologia, stack software e workload esatti.

Business case · iso-topologia a 8.192 GPU

Che cosa cambia a 8.192 GPU? I costi a cinque anni.

Questo caso analitico confronta 256 moduli GRIFO 32 con 1.024 nodi convenzionali a 8 GPU. Entrambi contengono 8.192 GPU; ogni nodo dispone di 8 × 400G di uplink. Le stime seguenti riguardano questo preciso scenario infrastrutturale e operativo.

8,192Un caso comparabile a 8.192 GPU
018.192

acceleratori H200 in entrambe le architetture

02256

domini GRIFO 32 · 32 GPU ciascuno

031.024

nodi DGX convenzionali · 8 GPU ciascuno

048 × 400G

uplink per nodo · fat-tree non-blocking

01 · CAPEX≈ €95M

in meno al punto medio degli intervalli pubblicati

€400–485M convenzionale · €305–390M GRIFO 32
02 · OPEX · 5 ANNI≈ €76M

in meno tra energia, MRO, personale e ricambi

€132M convenzionale · €56M GRIFO 32
03 · TCO · 5 ANNI≈ €171M

in meno alla stessa scala di 8.192 GPU

circa il 30% sotto il modello del cluster convenzionale
VANTAGGIO TCO PROPORZIONALE

Più GRIFO. Più valore assoluto trattenuto.

La curva applica proporzionalmente il risultato TCO pubblicato a 8.192 GPU ai checkpoint del deployment. Mostra l’effetto economico che si accumula mentre GRIFO sostituisce più confini tra server convenzionali; i valori intermedi sono interpolazioni, non quotazioni autonome.

Unità GRIFO 32 · scala GPU equivalenteVantaggio cumulativo stimato
CAPEX + OPEX

Da dove nasce il vantaggio a cinque anni

Il modello separa il capitale necessario a costruire l’infrastruttura dal costo operativo richiesto per mantenerla in funzione.

Cluster convenzionaleGRIFO 32
CAPEX
€400–485M
€305–390M
OPEX · 5 ANNI
≈ €132M
≈ €56M
TCO TOTALE
€532–617M
€361–446M
PHYSICS → OPEX

Il motore dell’OPEX è fisico

0115,58 → 6,74 MW

potenza al wall a 8.192 GPU

02387 GWh

energia evitata in cinque anni

03€58,1M

costo energia evitato a €0,15/kWh

Stai valutando un progetto più piccolo?

Il confronto parte dalle stesse voci: host, NIC, switch, ottiche, alimentazione e raffreddamento. Su una o poche macchine, il vantaggio va calcolato sulla configurazione e sull’utilizzo effettivi. Il caso a 8.192 GPU illustra la scala del fenomeno; non determina il risparmio del tuo progetto.

“Il valore si accumula consolidando l’infrastruttura ripetuta dei server.”
BUSINESS CASE ANALITICO — NON UN’OFFERTA COMMERCIALE

Fonte: GRIFO 32 Cluster 8,192 GPU — Business Edition Rev. 1.1, aprile 2026. I valori sono stime di ordine di grandezza per il caso di riferimento iso-topologico NVIDIA H200 dichiarato, pieno carico 24/7, €0,15/kWh e orizzonte di cinque anni. Il vantaggio CAPEX usa il punto medio degli intervalli pubblicati; i valori intermedi di scala sono interpolazioni proporzionali. I costi reali dipendono da configurazione, workload, acquisti, facility, utilizzo e prezzo dell’energia.
Perché conta l’architettura

Il picco dei componenti non garantisce prestazioni utili.

Una specifica di picco descrive ciò che un singolo componente potrebbe fare in condizioni ideali. Il lavoro reale termina soltanto se i dati raggiungono gli acceleratori, la memoria li alimenta, il fabric li coordina, il software li utilizza bene e alimentazione e raffreddamento sostengono la macchina per l’intera elaborazione.

PROMESSA DEL COMPONENTEPICCO TEORICO

Ciò che l’acceleratore potrebbe calcolare quando tutte le condizioni di supporto sono ideali.

UN NUMERO SULLA SCHEDA TECNICA
IL PERCORSO CHE OGNI WORKLOAD DEVE ATTRAVERSARE01—06
01Workload
02Località dei dati
03Memoria
04Fabric
05Software
06Energia + raffreddamento
RISULTATO DEL SISTEMAPRESTAZIONE UTILE

Quanto lavoro corretto il sistema completo termina davvero per unità di tempo, energia e costo.

UN RISULTATO MISURABILE
LA REGOLA ARCHITETTURALE
Il passaggio necessario più lento determina il ritmo dell’intero sistema.

Se dati, memoria, fabric, software o raffreddamento rallentano, gli acceleratori aspettano. Aggiungere altro picco non elimina l’attesa: bisogna riprogettare il percorso completo.

PICCO ≠ RISULTATO · GOVERNA IL TAGLIO RILEVANTE PIÙ STRETTO
01
Workload

La macchina deve essere coerente con modello, precisione, batch e tempo richiesto per ottenere il risultato.

02
Località dei dati

I dati devono essere già vicini al calcolo, non in attesa oltre confini tra server distanti.

03
Memoria

La capacità mantiene residente il problema; la banda alimenta gli acceleratori al ritmo richiesto.

04
Fabric

Ogni scambio e sincronizzazione richiede banda sufficiente, latenza abbastanza bassa e comportamento prevedibile.

05
Software

Driver, runtime e orchestrazione devono presentare l’hardware come un unico sistema coordinato.

06
Energia + raffreddamento

L’impianto deve sostenere clock e densità per l’intera elaborazione, non soltanto per pochi secondi.

Prove documentate

Specifiche, validazione di sistema e risultati misurati.

Configurazioni di riferimento e perimetro di validazione sono distinti dagli studi analitici.

01 · SPECIFICA DOCUMENTATA

Sistema di riferimento GRIFOTTO

8 posizioni GPU Gen5 x16 · configurazione dual Xeon · 2 TB di memoria · I/O pronto per 400G

02 · SPECIFICA ARCHITETTURALE

Architettura GRIFO 32

Fino a 32 acceleratori PCIe full-length · un fabric commutato Gen5 single-root · raffreddamento a liquido by design

03 · PIANO DI VALIDAZIONE

Protocollo di validazione

Alimentazione · firmware · BMC · topologia GPU/PCIe/NUMA · controlli di rete e GPUDirect

BENCHMARK POLICYI risultati dei benchmark applicativi saranno pubblicati solo indicando configurazione esatta, workload, versioni software e condizioni di misura.

Soluzioni

Partire dal problema, non dalla distinta base.

Definiamo workload, percorso dei dati, vincoli dell’impianto e criteri di successo prima di configurare la macchina.

01

AI privata e sovrana

Conoscenza, modelli e workflow sotto il controllo diretto dell’organizzazione.

CONFIDENTIALGPT + GRIFO
02

AI ad alta densità

Più acceleratori in un dominio locale, con termica e impianto progettati insieme.

GRIFO 32
03

Calcolo scientifico

Simulazione, analytics accelerata e AI in un sistema orientato al workload.

GRIFOTTO + GRIFO
04

Analytics GPU-native

Operazioni relazionali, vettoriali e AI più vicine alla memoria degli acceleratori.

GRIFO DATA ENGINE
Emilio Billi, Founder, CTO and System Architect

Fondatore e System Architect

Emilio Billi — l’architetto dietro GRIFO.

Da oltre vent’anni, tra Europa e Stati Uniti, Emilio Billi lavora su HPC, scale-up PCIe, memoria condivisa, sistemi accelerati e co-design hardware-software. Il suo metodo parte dal percorso del dato e trasforma i limiti fisici in decisioni progettuali.

“Il sistema è il prodotto. La misura è la prova.”
01 · Modello02 · Numeri03 · Misura04 · Decisione
AI Infrastructure senza nebbia — Emilio Billi

LAVORO SELEZIONATO · 2026

AI Infrastructure
senza nebbia
Leggi il profilo completo e i lavori

Azienda

Una deep-tech europea guidata dal suo fondatore.

Billi Dynamics S.r.l. trasforma l’architettura di sistema in prodotti industriali per AI, calcolo scientifico, analytics e installazioni mission-critical.

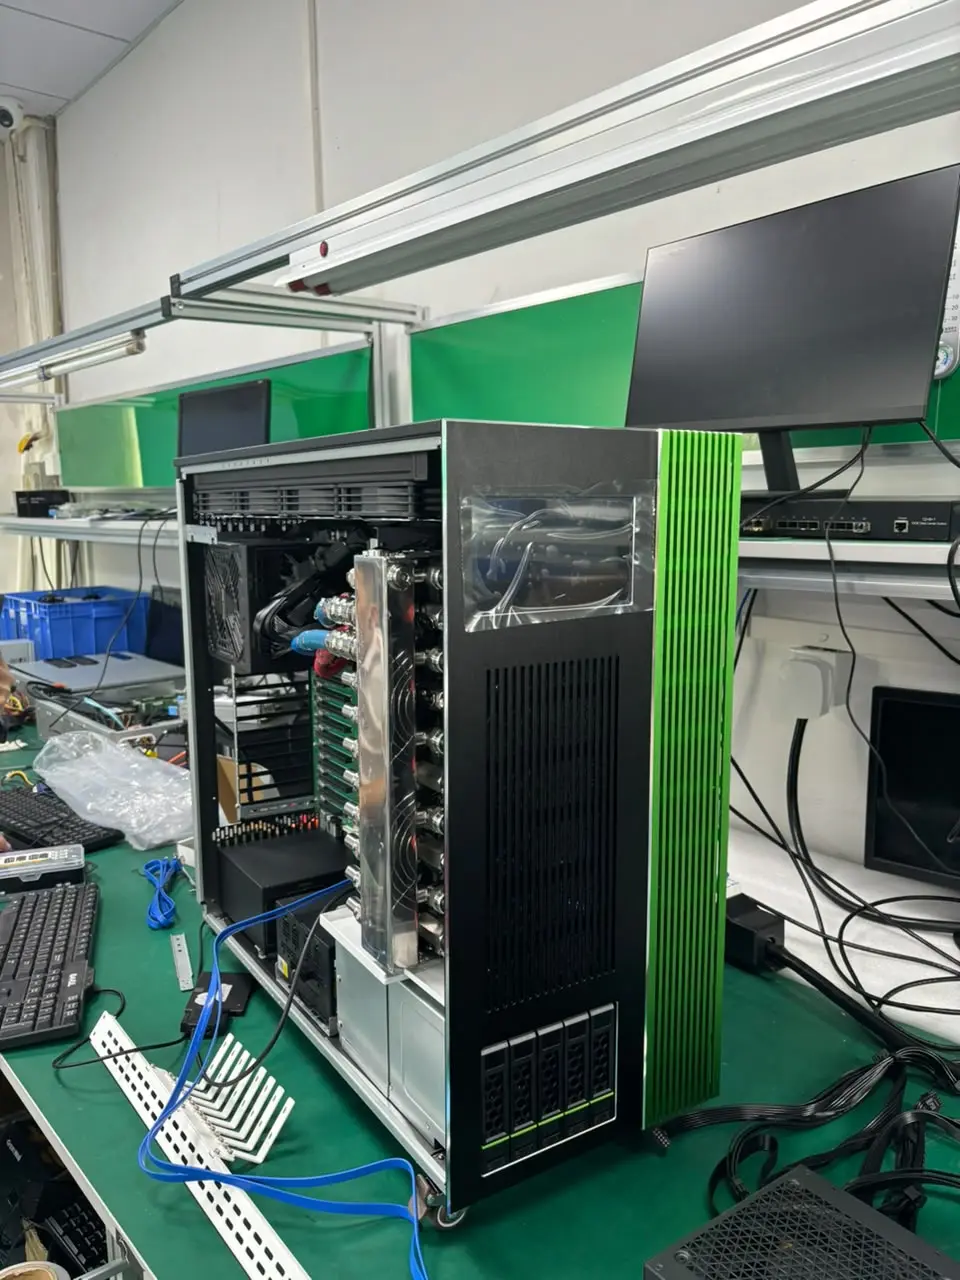
GRIFOTTO laboratory assembly

ENGINEERING PROOFAssemblaggio e validazione reale dei sistemi nel laboratorio Billi Dynamics.

Leadership e board

Emilio Billi

Emilio Billi

Founder & CTO (acting CEO)

Imprenditore deep-tech e system architect con oltre 20 anni in HPC, infrastrutture AI e co-design hardware-software.
01
Pietro Camasta

Pietro Camasta

BizOps

Collega operations, strategia ed esecuzione per sostenere una crescita controllata.
02
P.F. Girard

P.F. Girard

Board Member

Leader industriale con esperienza in innovazione, digitalizzazione, eccellenza operativa e crescita.
03
Christopher Shelton-Agar

Christopher Shelton-Agar

CSO

Leader commerciale e strategico per posizionamento, alleanze e crescita dei ricavi.
04

Partiamo dal workload

Raccontaci che cosa deve realizzare la macchina.

Raccontaci la tua applicazione e la scala di cui hai bisogno. Il primo confronto tecnico aiuta a definire una configurazione adatta, i requisiti di installazione e il percorso di validazione sul tuo workload.

  1. Applicazione e obiettivo

    Definiamo dati, modelli, capacità e tempi richiesti.

  2. Configurazione e impianto

    Valutiamo sistema, acceleratori, I/O, alimentazione e raffreddamento.

  3. Validazione e accompagnamento

    Concordiamo quali test servono e il perimetro di installazione, messa in servizio e assistenza da includere nella proposta.

MODEL · NUMBERS · MEASUREMENT · DECISION

Il modulo prepara un’email. Per completare la richiesta, invia il messaggio dal tuo programma di posta.